04 Job Monitoring
Job Monitoring responde primero si se hizo el trabajo y después ayuda a localizar dónde y cuándo se concentra el impacto batch.
Qué aparece
| Panel | metricId o dataset | Lectura |
|---|---|---|
| Failed jobs · Last 15 min | failed-jobs | Incrementos de errores batch durante los 15 minutos anteriores al final del rango |
| Canceled jobs · Last 15 min | canceled-jobs | Ejecuciones únicas canceladas durante los 15 minutos anteriores al final del rango |
| Long-running jobs · Current · >120 min | long-running-jobs | Snapshot actual de jobs en ejecución por encima de 120 minutos |
| Long-running work processes by server | long-running-work-processes | Duración CCMS en segundos, separada por servidor |
| Maximum long-running work processes (24 h) | long-running-work-processes | Máxima duración real en 24 horas por servidor; el donut sólo contiene servidores reales |
| Background work processes | job-metrics | Capacidad NumberOfWpBTC por servidor, como línea escalonada |
| Background work-process errors | failed-jobs | Incrementos de ErrorsInWpBTC por servidor, como barras |
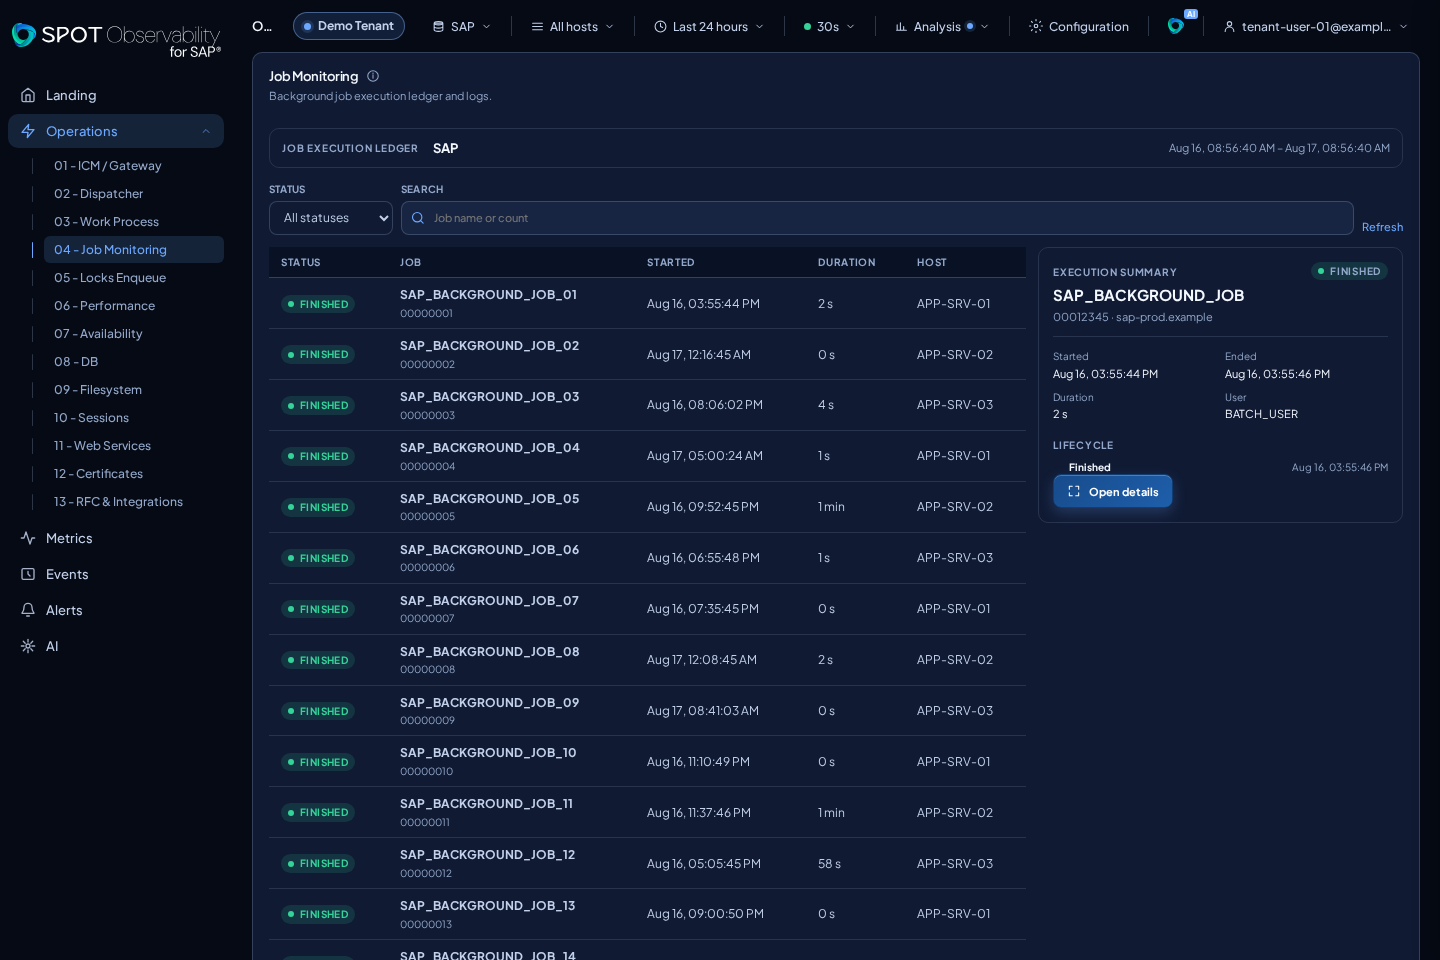
| Job families | Jobs | Familias por nombre SAP exacto, con actividad en el rango |
| Job Runs | Jobs | Ejecuciones de una familia y su detalle |
| Job Events | Events | Eventos relacionados con jobs |
Failed jobs no muestra directamente el contador acumulado de SAP
ErrorsInWpBTC. SPOT deduplica cada observación por TID y calcula los
incrementos positivos por servidor. Si el contador se reinicia, el valor nuevo
es el incremento; si falta una muestra anterior reciente o el hueco supera
15 minutos, el resultado es UNKNOWN. Un cero sólo se muestra cuando existe
cobertura válida.
Canceled jobs cuenta ejecuciones job_run únicas con estado SAP A en
(to-15m, to]; no depende del Job Log. Failed jobs usa el mismo final de
rango: el KPI representa esa ventana móvil, mientras su gráfica conserva todo
el rango solicitado. El timestamp terminal y el servidor proceden de la propia
ejecución autoritativa.
Long-running jobs usa snapshots XBP por servidor. El conector selecciona
jobs SAP en estado R y cuenta sólo los que llevan más de 120 minutos:
exactamente 120:00 queda fuera y 120:01 entra. Un cero fresco es una observación
válida; UNKNOWN significa ausencia, error o pérdida de frescura. SPOT no
utiliza Work Processes, datos de demostración ni un cero inventado como
sustituto.
Cuando SAP representa una selección válida sin resultados, SPOT sólo publica
cero después de validar tanto el código de retorno como una tabla de resultados
presente y vacía. Cualquier otra respuesta permanece UNKNOWN: un error SAP
general nunca se convierte en cero.
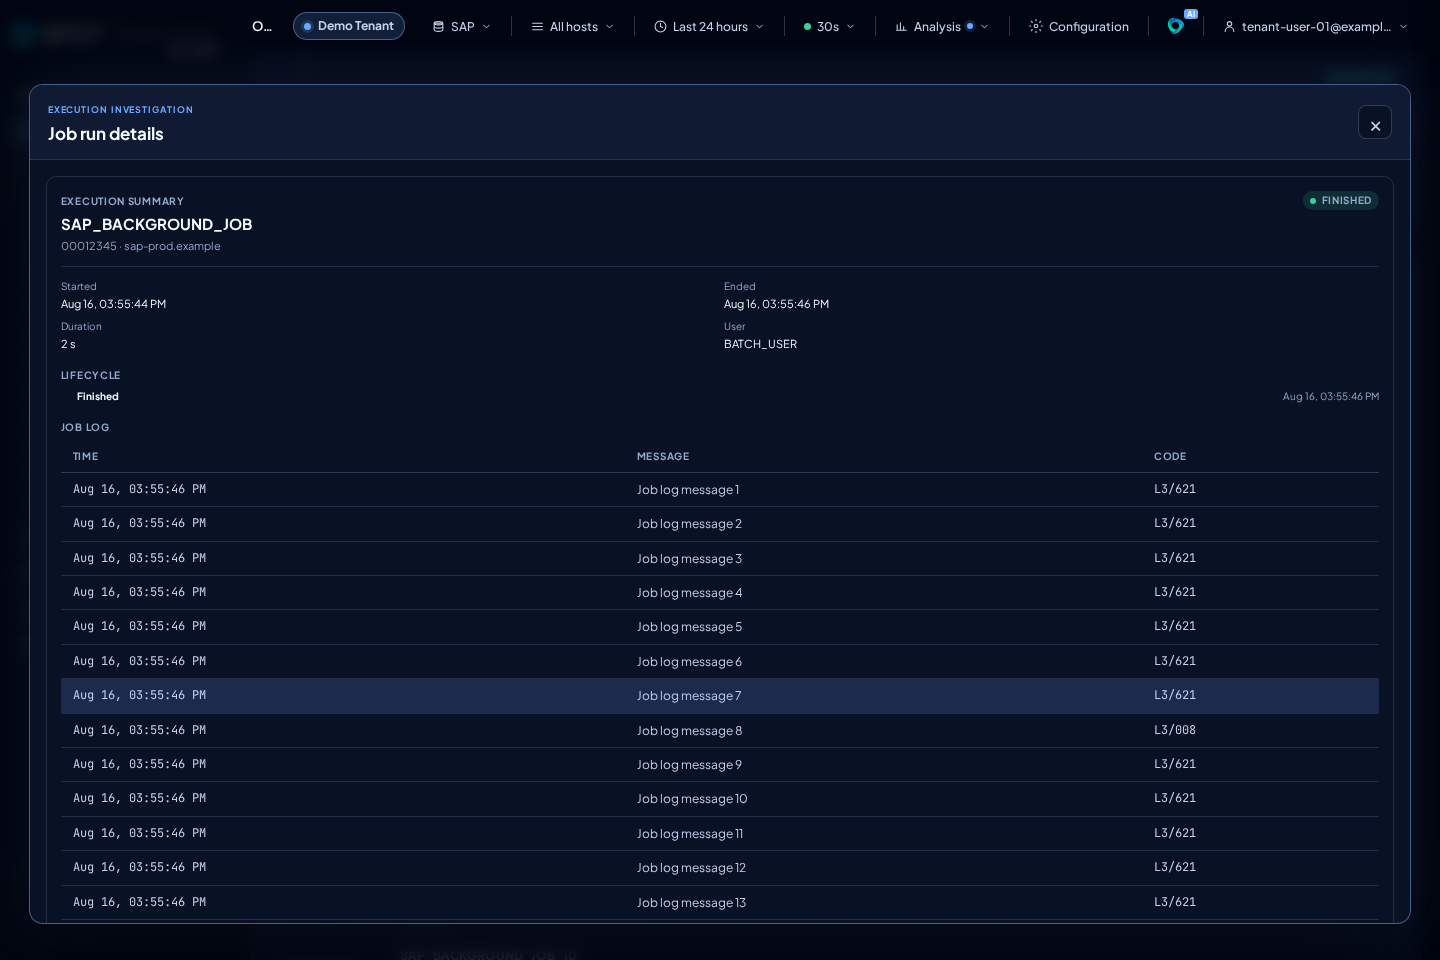
SPOT recoge el Job Log completo de una ejecución terminal de forma asíncrona. La cola de logs no detiene las siguientes observaciones de jobs. En el detalle, el manifiesto indica Queued, Collecting, Retrying, Complete, No entries, Too large, Not authorized, Unavailable o Collection failed. SPOT nunca presenta un log parcial como completo: espera a confirmar las líneas antes de marcarlo como Complete. Si el log es demasiado grande o SAP no lo ofrece, la ejecución, su lifecycle y el resto de la investigación siguen disponibles.
Long-running work processes es una señal de duración en segundos, no un recuento de procesos ni un sustituto de los jobs en ejecución.
Los tres resultados funcionales aparecen como KPI equivalentes. El detalle de
Long-running work processes comparte composición con su máximo de 24 horas,
en proporción 8/4. La composición Background processing by server mantiene
dos gráficas separadas y sincronizadas: capacidad NumberOfWpBTC arriba y
deltas de errores abajo. Comparten cursor temporal, leyenda y color por
servidor, pero usan ejes enteros independientes desde cero. Cuando todos los
deltas cubiertos son cero se indica explícitamente que no hubo errores; un
bucket UNKNOWN impide mostrar ese mensaje. Job Runs y Job Events mantienen
paneles propios; los dumps se investigan exclusivamente en Work Process.
En Job families, cada fila representa el JOBNAME exacto: una familia
operativa para investigar, no una definición inmutable del planificador SAP.
Las columnas separan el estado y la última actividad de la duración de la
ejecución más reciente (Last run time). Una duración real de cero se muestra
como 0 s; si esa ejecución no tiene una duración válida, aparece —.
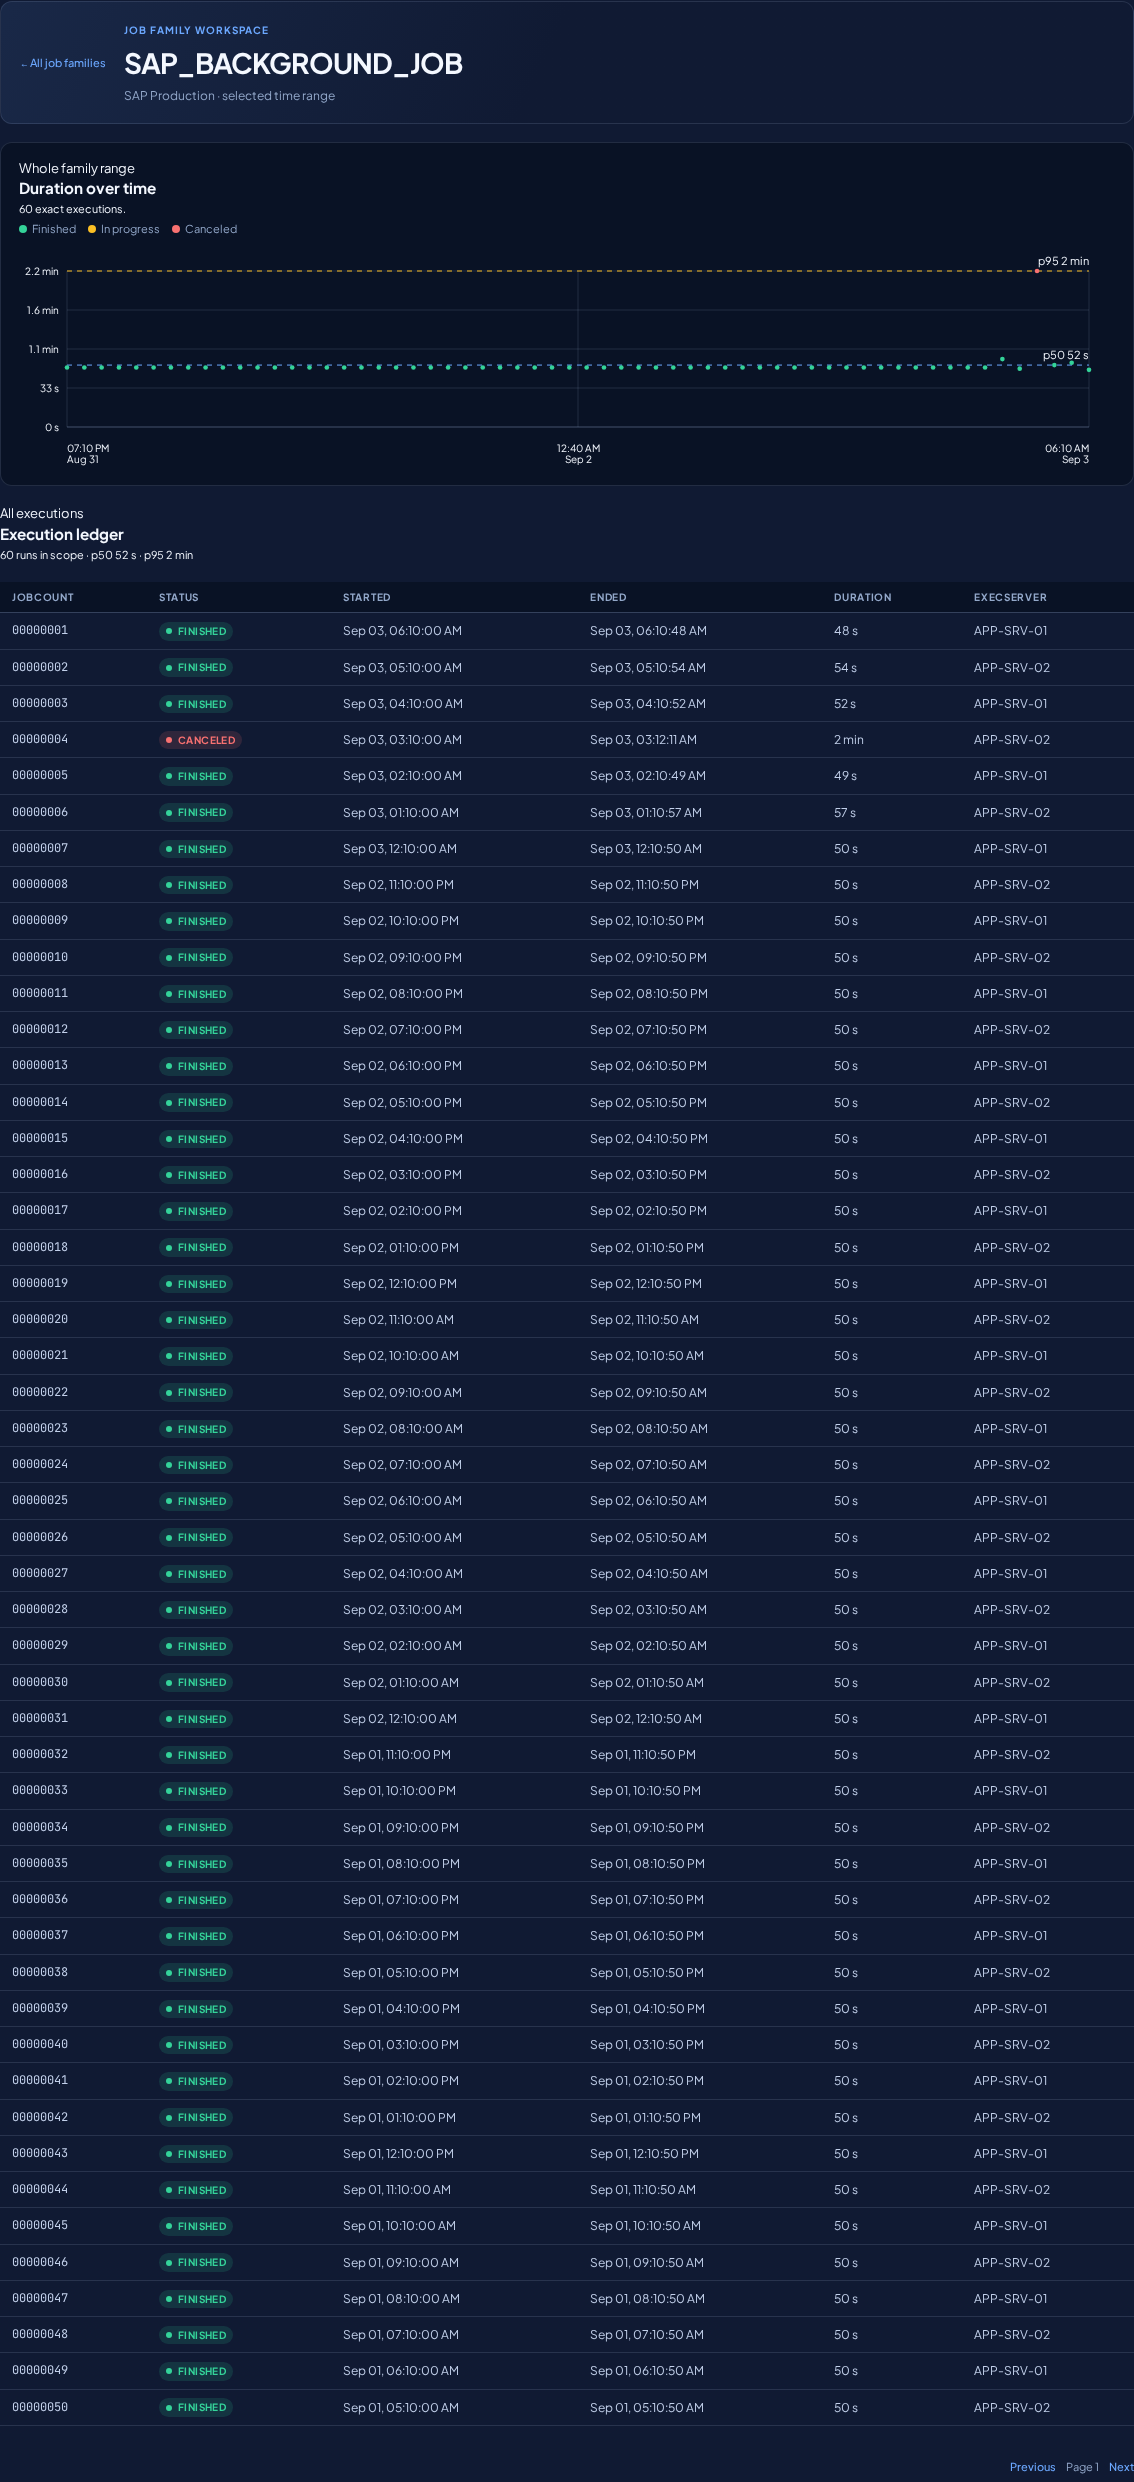
Al seleccionar una familia se abre su espacio de trabajo dedicado a todo el
ancho con la source, el filtro de host y el rango temporal activos. La
cronología de duración cubre toda la familia dentro del scope, con independencia
del ledger paginado. Hasta 1.000 ejecuciones muestra cada punto exacto; para
familias mayores resume intervalos y conserva ejecuciones reales mínimas,
máximas y representativas, además de los recuentos por estado. El ledger sigue
siendo la vista exhaustiva paginada y mantiene la identidad SAP JOBNAME + JOBCOUNT, el estado, inicio, fin, duración y EXECSERVER. Las duraciones
desconocidas permanecen desconocidas y no se convierten en cero. Cuando hay
muchos puntos, su marca visible se reduce de forma gradual, mientras el área de
selección y el realce de teclado o puntero siguen siendo accesibles.
Selecciona un JOBCOUNT o un punto exacto de la gráfica para abrir directamente
el detalle de ejecución. El resumen permanece siempre visible y sólo hay dos
pestañas: Job Log, seleccionada al abrir, y Retained history. Escape
cierra el detalle y devuelve el foco al control que lo abrió. Usa All job
families para volver a la lista con sus filtros, página y posición de lectura.
Selección y evidencia retenida
El rango global, la conexión SAP seleccionada, el source que ésta representa y el filtro de host determinan si una ejecución puede seleccionarse. Una vez que SPOT valida la ejecución en ese contexto, recupera su lifecycle, el estado del manifiesto y el Job Log retenido completos, incluso si la recogida de esas pruebas terminó fuera de la ventana temporal visible. Esta recuperación no amplía el alcance: conserva siempre la misma conexión/source, tenant y host.
El resumen de hosts de una familia cubre toda la familia dentro del rango, no
sólo los runs que aparecen en la página actual del ledger. Los nombres SAP se
tratan como nombres exactos; puede buscarse una familia cuyo nombre use
puntuación, por ejemplo +.
Un enlace compartido puede contener familia y ejecución. Si esa ejecución pertenece a otra familia o ya no está disponible en el contexto activo, SPOT conserva la familia, limpia sólo la ejecución y no muestra el Job Log de otra familia. Selecciona una ejecución de la tabla para continuar la investigación.
Interpretación
- OK: no hay fallos o cancelaciones relevantes en el intervalo observado.
- WARN: fallos repetidos, cancelaciones crecientes o presión batch concentrada en un servidor.
- KO: impacto sostenido en trabajos críticos o degradación simultánea de jobs y capacidad batch.
UNKNOWN: falta una señal fresca. En Long-running jobs, revisa permisos XBP, zona horaria de la conexión y Agent logs.
Un 0 en Canceled jobs es válido cuando el intervalo ha sido observado sin
cancelaciones mediante una consulta correcta. Si el Data Stream logs no está
disponible o el productor no es schema v2, el resultado es UNKNOWN o
producer_upgrade_required, no cero. En
Long-running jobs, un 0 también es válido, pero sólo cuando procede de un
snapshot XBP correcto. La misma ejecución cancelada se deduplica por identidad
de job_run.
Filtros y siguientes pantallas
Filtra por rango global, texto o nombre exacto, estado y host. Empieza por una
familia; después compara los JOBCOUNT de sus ejecuciones en distintos hosts y
abre la que se aleja de p50/p95. Si el manifiesto no está Complete, revisa
su estado antes de concluir que no hubo mensajes. Usa Job Events para mensajes
actuales asociados. Cruza con Work Process para capacidad batch y dumps, DB
para latencia y Filesystem si el job escribe spool o exportaciones.
Uso operativo
Job Monitoring resume el resultado batch sin obligarte a entrar primero en la tabla completa. Los tres KPI funcionales también aparecen en Landing; el resto de paneles aporta el detalle por servidor y el historial.
Si hay fallos, cancelaciones o ejecuciones lentas repetidas por nombre, abre la familia y compara cada ejecución y sus eventos. Si coinciden con DB request time alto o falta de procesos batch, cruza con DB y Work Process antes de atribuir el problema únicamente al job.