Agent logs
Agent logs muestra eventos estructurados enviados por los pull connectors SaaS. La vista sirve para diagnosticar instalación, pull de configuración, heartbeat, extracción SAP, escrituras Elastic y upgrades gestionados sin entrar al host.
Los logs remotos son best-effort: si una escritura de log falla, el agente no bloquea la extracción SAP ni el heartbeat. La retención operativa es corta, orientada a troubleshooting reciente.
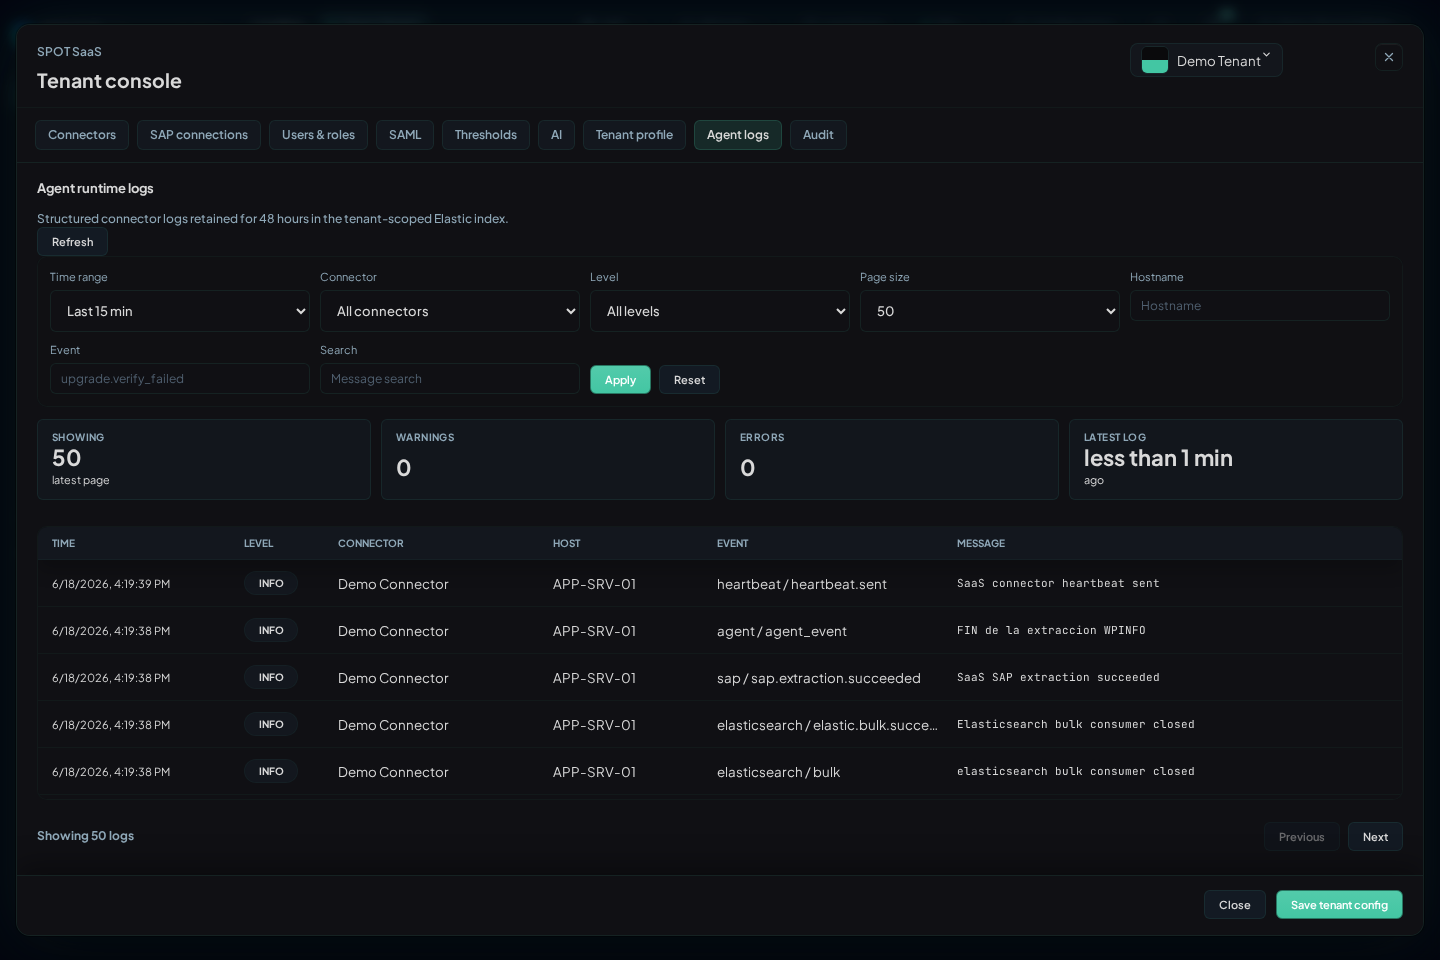
Filtros
| Filtro | Uso |
|---|---|
Time range | Por defecto muestra los últimos 15 minutos; usa rangos mayores para upgrades o incidencias ya cerradas |
Connector | Aisla un runtime cuando el tenant tiene varios agentes |
Level | info, warn o error; empieza por error si hay un connector NOK |
Hostname | Filtra por host reportado por el agente; usa nombres sanitizados en reportes externos |
Event | Busca eventos concretos como config.pull.failed, sap.extraction.failed o upgrade.verify_failed |
Search | Busca texto libre en mensaje y campos principales |
Page size | Ajusta el número de filas por página |
La tabla muestra Time, Level, Connector, Host, Event y Message. Al expandir una fila ves el JSON completo del evento. No copies salidas completas a tickets si contienen rutas internas, hostnames o identificadores; comparte solo el fragmento sanitizado relevante.
Eventos importantes
| Familia de evento | Qué indica | Siguiente comprobación |
|---|---|---|
config.pull.started / config.pull.succeeded | El agente está pidiendo configuración SaaS | Revisa Config en Connectors si no sube la revisión aplicada |
config.pull.not_modified | La revisión local ya coincide con SaaS | Normal si no hubo cambios en SAP connections o upgrades |
config.pull.failed | El agente no puede obtener configuración | Salida HTTPS, credencial local, reenrolado |
heartbeat.sent / heartbeat.failed | Estado de vida del connector | Si falla, revisa red y control plane |
sap.extraction.started / sap.extraction.succeeded | Extracción SAP en curso o correcta | Cruza con Metrics y Operations |
sap.extraction.failed | RFC, permisos SAP o datos no disponibles | Revisa usuario técnico, ASHOST, SYSNR y familia habilitada |
sap.collection.schedule.completed | Fase real y duración de cada source/familia | Compara scheduled_at, start_delay_ms, duration_ms y skipped_cycles |
sap.programs.progress | Cobertura confirmada de Programs por fuente | Compara coveredThrough, lagSeconds, pendingWindows y state en observaciones sucesivas |
elastic.bulk.succeeded / elastic.bulk.failed | Escritura al target tenant | Si falla, revisa conectividad de ingesta y target del tenant |
upgrade.* | Fases de descarga, verificación, instalación y reinicio | Cruza con Request upgrade en Connectors |
Diagnóstico por síntomas
| Síntoma | Filtro recomendado | Lectura |
|---|---|---|
Connector Pending | Connector + últimos 30 minutos | Si no hay logs, el agente no arranco o no se enroló |
Connector Stale | Connector + heartbeat | Heartbeat detenido; revisar servicio de usuario o salida HTTPS |
| Config no aplicada | Connector + config.pull | Si aparece fallo de pull, reenrolar o revisar conectividad |
| Dashboards vacíos | Connector + sap.extraction y elastic.bulk | Diferencia si falla SAP, escritura o simplemente no hay datos en rango |
| Programs atrasado | Connector + sap.programs.progress | Compara el cursor confirmado con la hora actual; un documento recién recibido puede cubrir historia antigua |
| Upgrade fallido | Connector + upgrade | Validar checksum/firma, espacio en disco y supervisor |
Cadencia y recursos
Observed/@timestamp es la hora SAP, ingested_at la recepción y el eje del
gráfico muestra el inicio del bucket. Para diagnosticar desfase usa los cuatro
datos juntos. Los ciclos omitidos se consolidan y no forman una cola.
El heartbeat expone contadores agregados allowlisted de RSS/PSS, heap/GC/cgo,
goroutines, threads, dispatcher, RFC, filas, documentos y bytes. Calcula CPU entre dos valores de process_cpu_time_ns; un único valor acumulado no es un porcentaje.
Para Programs, coveredThrough y lagSeconds reflejan sólo cobertura confirmada por ACK; windowSeconds muestra el ancho de hoja y pendingWindows las hojas pendientes. current significa que el atraso no supera el intervalo configurado más 120 segundos; catching_up indica recuperación y backoff espera tras un fallo. Antes del primer cursor confirmado, la frescura es desconocida y los campos de cobertura y estado pueden no aparecer. Observa varios eventos: la recepción reciente por sí sola no demuestra que Programs esté al día.
Jobs cambia durante la lectura
SAP no ofrece un snapshot estable para la paginación de TBTCO. El connector comprueba cada recorrido completo antes de publicar datos. Si los jobs cambian entre páginas, el ciclo de Jobs termina con un error saneado, no publica una vista incompleta y no avanza su cursor; el siguiente ciclo estable vuelve a leer desde el inicio. Una interrupción entre una página y su progreso confirmado tampoco mezcla ejecuciones antiguas y nuevas. Un caso aislado puede coincidir con actividad batch normal. Si se repite, revisa duración de la extracción, carga SAP y permisos de lectura antes de ampliar intervalos o límites.
En tablas de más de 500 filas, el connector acuerda con SAP un único modo de
ordenación antes de publicar la primera página. Un mensaje repetido sobre
ROWSKIPS u ordenación indica que esa familia no completó el ciclo: comprueba
por separado la frescura de Job Runs o RFC failures, porque un snapshot
agregado de Jobs correcto no demuestra que esos listados paginados terminaran.
El connector recoge el Job Log completo de cada ejecución terminal mediante la
BAPI estándar. La lectura es asíncrona y no bloquea el cursor de job_runs ni
el snapshot de long-running jobs. Como SAP no pagina la respuesta, durante una
lectura grande puede aumentar transitoriamente el uso de memoria del agent. En
el detalle, revisa el manifest: complete o empty son resultados confirmados;
retrying, too_large, unauthorized, unavailable o error explican por
qué el log aún no está disponible. SPOT nunca interpreta una recogida parcial
como un log completo o vacío.
SAP devuelve una estructura incompleta
Las tablas y listas obligatorias de RFC failures, qRFC y Certificates se validan antes de publicar. Si SAP omite una estructura, devuelve una forma incompatible o corta una enumeración, el ciclo termina con un error saneado y conserva el último estado confirmado. No se interpreta como cero, lista vacía, retirada ni recuperación. Un resultado explícitamente vacío con la estructura correcta sí es válido.
En Certificates, una lista de descubrimiento vacía no impide comprobar los contextos PSE canónicos. Si alguno existe, el inventario se publica; permisos insuficientes, estructuras malformadas u otros errores RFC siguen fallando de forma cerrada.
Alertas CCMS sin texto SAP
Una alerta CCMS puede incluir identidad, fecha y valor válidos aunque SAP no devuelva su texto explicativo. El connector no descarta por ello el ciclo: publica un mensaje operativo estable y marca la procedencia como fallback. No confundas este caso con un fallo RFC. Un error real de autorización, una respuesta corrupta o la ausencia del valor requerido sí dejan la colección en error y no avanzan su watermark.
El diagnóstico de extracción distingue nodos elegibles, alertas candidatas, eventos emitidos, fallbacks de mensaje y fallos reales. Por tanto, el número de nodos elegibles no representa cuántos mensajes faltan.
Relación con logs locales
El host mantiene logs locales en:
$HOME/spot-agent-saas/log/spot-agent-sap.log
Usa los logs remotos para diagnóstico normal desde SPOT. Entra al host solo si necesitas validar systemd --user, linger, permisos de fichero o conectividad local.